](/media/header/doctor.jpg)
Regression und ANCOVA
Inhaltsverzeichnis
Einleitung
In diesem ersten Beitrag zur Methodenlehre im Master “Klinische Psychologie und Psychotherapie” (ab sofort einfach immer auf KliPPs abgekürzt) geht es darum, an einem konkreten Beispiel aus der aktuellen klinischen Forschung noch einmal die Grundideen der multiplen Regression und ANCOVA zu wiederholen. Alle relevanten Informationen noch mal in einem Beitrag aufzubereiten kann etwas kurz geraten, deswegen möchte ich an dieser Stelle noch auf die etwas umfangreicheren Einzelbeiträge aus dem Bachelorstudiengang zur multiplen Regression, der Prüfung der Voraussetzungen in der multiplen Regression, zur Inferenz und Modellauswahl und zur moderierten Regression hinweisen. Dort finden Sie mehr Details, falls Ihnen der Überblick hier etwas zu oberflächlich erscheint.
Die ANalysis of COVAriance hatten wir bereits im 2. Semester der Bachelorstudiengangs behandelt und dabei schon vorausahnen lassen, dass wir uns das Ganze im Rahmen des KliPPs-Masters noch einmal detaillierter angucken werden. Dieser Spannungsbogen soll nun hier nun endlich geschlossen werden.
Im Allgemeinenen wird die ANCOVA in der Psychotherapieforschung immer dann genutzt, wenn wir Interventionsgruppen betrachten werden, die sich zum ersten Zeitpunkt hinsichtlich des Outcomes oder beliebiger Kovariaten unterscheiden können. Hierbei ist besonders wichtig zu unterscheiden, ob es sich um randomisierte Studien (üblicherweise “Randomized Controlled Trial”, kurz RCT, genannt) handelt oder nicht. Üblicherweise sollten sich die Gruppen im ersten Fall nicht systematisch unterscheiden, aber wir werden im Abschnitt zum Dropout noch genauer darauf eingehen, wie so etwas trotzdem entstehen kann. Darüber hinaus werden wir einige kritische Entscheidungen und Abgrenzungen besprechen, z.B. wann es empfehlenswert ist als abhängige Variable die Differenz aus den zwei Messzeitpunkten (also den Indikator der Veränderung) statt des Messwerts zum 2. Zeitpunkt zu nutzen.
Die Kommunikationskompetenz von Ärzt*innen
In einer recht aktuellen Studie von Kube und Seewald (2026) (der Erstautor wird Ihnen im Rahmen dieses Studiums vermutlich noch einmal über den Weg laufen), wurde experimentell untersucht, welchen Einfluss Wärme und Kompetenz von Ärzt*innen auf die Reaktion von Patient*innen haben, wenn ihnen unauffällige diagnostische Befunde mitgeteilt werden.
Diese Studie ist - wie alle Studien, mit denen wir uns in diesem Semester befassen werden - auf dem OSF zu finden. Dort wurden die Daten aber leider einer JASP Datei integriert hinterlegt, sodass wir sie nicht direkt in R importieren können. Stattdessen habe ich Ihnen eine bereinigte und aufbereitete Variante des Datensatzes hinterlegt, den Sie auch direkt mit
load(url('https://pandar.netlify.app/daten/roma.rda'))
laden können.
Im Datensatz sind insgesamt 23 Variablen enthalten, von denen zwar nicht alle zentral für die ANCOVA Ergebnisse aus der Studie sind, aber zumindest in den Tabellen der Studie aufbereitet werden.
Variablenübersicht
| Variable | Beschreibung | Ausprägungen |
|---|---|---|
id | Personen-ID | |
age | Alter | in Jahren |
gender | Geschlecht | male, female, diverse |
education | Bildungsniveau | primary, high school, university, none |
occupation | Aktuelles Beschäftigungsverhältnis | full-time employ, part-time employ, stay at home, in training, unemployed, retired, disabled |
sss8 | Somatic Symptom Scale | Skalenwert, 0 - 32 |
ssd12 | Somatic Symptom Disorder-B Criteria Scale | Skalenwert, 0 - 48 |
phq9 | Patient Health Questionnaire | Skalenwert, 0 - 27 |
cimr | Cognitive Immunization Against Medical Reassurance | Skalenwert, 1 - 7 |
vignette | Ähnliche Symptome erlebt | yes, no |
report | Ähnlichen Befund erhaten | yes, no |
comp | Experimentelle Bedingung: Kompetenz | high, low |
warm | Experimentelle Bedingung: Wärme | high, low |
comp_perc | Wahrgenommene Kompetenz | VAS, 0-100 |
warm_perc | Wahrgenommene Wärme | VAS, 0-100 |
disease1 | Wahrscheinlichkeit einer schweren Erkrankung (vor Befund) | VAS, 0-100 |
disease2 | Wahrscheinlichkeit einer schweren Erkrankung (nach Befund) | VAS, 0-100 |
cancer1 | Wahrscheinlichkeit von Darmkrebs (vor Befund) | VAS, 0-100 |
cancer2 | Wahrscheinlichkeit von Darmkrebs (nach Befund) | VAS, 0-100 |
cognitive | Kognitive Wahrnehmung der eigenen Gesundheit | VAS, 0-100 |
emotional | Besorgnis | VAS, 0-100 |
second | Wunsch nach zweiter Meinung | VAS, 0-100 |
colonoscopy | Wunsch nach Darmspiegelung | VAS, 0-100 |
Als zentrale Outcomes werden in dieser Studie die subjektiven Wahrscheinlichkeiten einer schweren Erkrankung (disease2) bzw. von Darmkrebs (cancer2) nach einem negativ-Befund (daher die 2) definiert. Darüber sind die vier letzten Variablen als Sekundäroutcomes in Abbildung 3 des Artikels noch einmal genauer betrachtet.
Deskriptivstatistik
In klinischen Studien ist es üblich (per CONSORT könnte man es fast schon vorgeschrieben nennen), in einer Table 1 alle relevanten deskriptivstatistischen Maße zur Baselinemessung anzugeben. Detaillierte Informationen dazu, wie eine solche Tabelle aussehen sollte, liefern z.B. Hayes-Larson et al., 2020. Dieser “Empfehlung” folgt auch dieser Artikel, was uns die Möglichkeit gibt, zu überprüfen ob wir tatsächlich mit identischen Daten arbeiten oder schon jetzt Probleme in der Reproduzierbarkeit zu entdecken sind.
Wir können die Table 1 berichteten Deskriptivstatistiken über die üblichen, einfachen Funktionen für einzelne Kennwerte bestimmen, die wir schon zu Beginn des 1. Bachelorsemesters behandelt haben. Weil die Tabelle allerdings Personen aus den vier Experimentalbedingungen trennt, sollten wir zunächst eine solche Variable aus den beiden einzelnen Variablen erstellen:
roma$condition <- roma$warm:roma$comp
Faktoren können wir mit dem : einfach zu einer Kombination zusammenführen. Falls Sie (wie ich) leicht den Überblick verlieren, wenn alle Benennungen gleich sind, können Sie diese Faktorkombination natürlich auch wieder mit Labels versehen:
roma$condition <- factor(roma$warm:roma$comp, labels = c('high warmth + high competence', 'high warmth + low competence', 'low warmth + high competence', 'low warmth + low competence'))
Dann lassen sich z.B. mit dem altbekannten describeBy() aus dem psych-Paket gruppierte Statistiken ausgeben.
psych::describeBy(roma[, c('condition', 'sss8', 'ssd12', 'phq9')], 'condition')
##
##  Descriptive statistics by group
## condition: 1
##           vars  n  mean   sd median trimmed  mad min max range skew kurtosis   se
## condition    1 89  1.00 0.00      1    1.00 0.00   1   1     0  NaN      NaN 0.00
## sss8         2 89  8.54 5.04      7    8.00 2.97   1  23    22 1.09     0.76 0.53
## ssd12        3 89 13.82 9.24     12   12.86 8.90   0  42    42 0.90     0.17 0.98
## phq9         4 89  7.80 5.21      7    7.32 4.45   0  24    24 0.87     0.39 0.55
## ------------------------------------------------------------------------------
## condition: 2
##           vars  n  mean   sd median trimmed  mad min max range skew kurtosis   se
## condition    1 83  2.00 0.00      2    2.00 0.00   2   2     0  NaN      NaN 0.00
## sss8         2 83  7.78 5.08      7    7.42 4.45   0  20    20 0.65    -0.49 0.56
## ssd12        3 83 13.19 8.98     12   12.33 8.90   0  40    40 0.82     0.07 0.99
## phq9         4 83  7.39 5.16      7    6.93 5.93   0  21    21 0.65    -0.34 0.57
## ------------------------------------------------------------------------------
## condition: 3
##           vars  n  mean    sd median trimmed  mad min max range skew kurtosis   se
## condition    1 93  3.00  0.00      3    3.00 0.00   3   3     0  NaN      NaN 0.00
## sss8         2 93  8.37  5.27      7    8.01 4.45   0  26    26 0.78     0.56 0.55
## ssd12        3 93 13.13 10.55     10   11.97 8.90   0  41    41 0.87    -0.11 1.09
## phq9         4 93  7.62  5.83      6    6.97 5.93   0  26    26 0.94     0.25 0.60
## ------------------------------------------------------------------------------
## condition: 4
##           vars  n  mean   sd median trimmed  mad min max range skew kurtosis   se
## condition    1 84  4.00 0.00      4    4.00 0.00   4   4     0  NaN      NaN 0.00
## sss8         2 84  8.36 4.59      8    8.01 5.93   0  22    22 0.53    -0.34 0.50
## ssd12        3 84 14.06 8.57     13   13.54 8.90   0  42    42 0.65     0.05 0.94
## phq9         4 84  7.61 4.71      7    7.18 4.45   1  24    23 0.97     0.96 0.51
Leider geht die Funktion nur bedingt gut mit unterschiedlichen Skalennvieaus um, sodass ich die Ausgabe hier auf die drei Skalenwerte (SSS-8, SSD-12 und PHQ-9) eingeschränkt habe. Für eine vollständig aufbereitete Table 1 gibt es aber inzwischen diverse Pakete und Funktionen. Eine Möglichkeit ist die tbl_summary() aus dem gtsummary-Paket, die wir z.B. gleichzeitig für verschiedene Formen von Variablen einsetzen können:
library(gtsummary)
tbl_summary(data = roma,
  by = condition,
  include = c(age, gender, ssd12))
| Characteristic | high warmth + high competence N = 89 | high warmth + low competence N = 83 | low warmth + high competence N = 93 | low warmth + low competence N = 84 |
|---|---|---|---|---|
| age | 25 (22, 35) | 26 (22, 37) | 25 (21, 30) | 24 (21, 30) |
| gender | ||||
| male | 22 (25%) | 16 (19%) | 16 (17%) | 13 (16%) |
| female | 63 (72%) | 66 (80%) | 76 (82%) | 70 (84%) |
| diverse | 3 (3.4%) | 1 (1.2%) | 1 (1.1%) | 0 (0%) |
| Unknown | 1 | 0 | 0 | 1 |
| ssd12 | 12 (7, 19) | 12 (6, 19) | 10 (5, 20) | 13 (7, 20) |
Wie zu sehen ist, sind wir schon mit dieser “out-of-the-box” Variante sehr nah an dem dran, wie eine Table 1 in einer Publikation aussieht. Die Dokumentation des Pakets enthält ein hervorragendes Tutorial zu den möglichen Einstellungen, die Sie so vornehmen können, um eine solche Tabelle nach Ihren Bedürfnissen anzupassen. Eine ziemlich gute Annäherung klapp schon mit diesen paar Zeilen:
tbl_summary(roma,
  by = condition,
  include = c(age, gender, education, occupation, sss8, ssd12, phq9, vignette, report),
  statistic = list(all_continuous() ~ "{mean} ({sd})", all_categorical() ~ "{n} ({p})"),
  digits = list(all_continuous() ~ 2, all_categorical() ~ c(0, 1)),
  label = list(age ~ "Age, y",
    gender ~ "Gender",
    education ~ "Educational level",
    occupation ~ "Occupation",
    sss8 ~ "SSS-8",
    ssd12 ~ "SSD-12",
    phq9 ~ "PHQ-9",
    vignette ~ "Had similar symptoms as described in the vignette",
    report ~ "Had a similar doctor's report in the past"),
  missing = "no") |>
add_overall(last = TRUE)
| Characteristic | high warmth + high competence N = 89 | high warmth + low competence N = 83 | low warmth + high competence N = 93 | low warmth + low competence N = 84 | Overall N = 349 |
|---|---|---|---|---|---|
| Age, y | 30.43 (13.00) | 31.64 (13.56) | 29.03 (13.17) | 28.62 (12.53) | 29.91 (13.07) |
| Gender | |||||
| male | 22 (25.0) | 16 (19.3) | 16 (17.2) | 13 (15.7) | 67 (19.3) |
| female | 63 (71.6) | 66 (79.5) | 76 (81.7) | 70 (84.3) | 275 (79.3) |
| diverse | 3 (3.4) | 1 (1.2) | 1 (1.1) | 0 (0.0) | 5 (1.4) |
| Educational level | |||||
| primary | 6 (6.7) | 3 (3.6) | 3 (3.2) | 1 (1.2) | 13 (3.7) |
| high school | 51 (57.3) | 41 (49.4) | 50 (53.8) | 50 (59.5) | 192 (55.0) |
| university | 31 (34.8) | 39 (47.0) | 40 (43.0) | 33 (39.3) | 143 (41.0) |
| none | 1 (1.1) | 0 (0.0) | 0 (0.0) | 0 (0.0) | 1 (0.3) |
| Occupation | |||||
| full-time employ | 19 (21.3) | 17 (20.5) | 22 (23.7) | 14 (16.7) | 72 (20.6) |
| part-time employ | 9 (10.1) | 15 (18.1) | 9 (9.7) | 12 (14.3) | 45 (12.9) |
| stay at home | 1 (1.1) | 1 (1.2) | 2 (2.2) | 0 (0.0) | 4 (1.1) |
| in training | 53 (59.6) | 47 (56.6) | 54 (58.1) | 53 (63.1) | 207 (59.3) |
| unemployed | 1 (1.1) | 1 (1.2) | 1 (1.1) | 1 (1.2) | 4 (1.1) |
| retired | 4 (4.5) | 2 (2.4) | 4 (4.3) | 4 (4.8) | 14 (4.0) |
| disabled | 2 (2.2) | 0 (0.0) | 1 (1.1) | 0 (0.0) | 3 (0.9) |
| SSS-8 | 8.54 (5.04) | 7.78 (5.08) | 8.37 (5.27) | 8.36 (4.59) | 8.27 (5.00) |
| SSD-12 | 13.82 (9.24) | 13.19 (8.98) | 13.13 (10.55) | 14.06 (8.57) | 13.54 (9.37) |
| PHQ-9 | 7.80 (5.21) | 7.39 (5.16) | 7.62 (5.83) | 7.61 (4.71) | 7.61 (5.24) |
| Had similar symptoms as described in the vignette | 74 (83.1) | 62 (74.7) | 80 (86.0) | 60 (71.4) | 276 (79.1) |
| Had a similar doctor’s report in the past | 48 (53.9) | 39 (47.0) | 45 (48.4) | 42 (50.6) | 174 (50.0) |
Wie wir sehen können, sind die Ergebnisse des Artikels soweit ziemlich genau reproduzierbar.
ANCOVA
Die zentralen statistischen Analysen des Artikels stellen die beiden ANCOVAs dar, in welchen untersucht wird, ob die Wärme und Kompetenz der Ärztin bzw. des Arztes einen Einfluss auf die subjektive Wahrscheinlichkeit einer schweren Erkrankung bzw. von Darmkrebs haben. Mit den Ansätzen aus Statistik II (spezifisch mit der aov_4() aus dem afex-Paket) können wir versuchen die berichteten Statistiken auf direktem Weg zu reproduzieren.
Die einfache Variante: ANOVA
Im Wesentlichen folgt das Vorgehen hier den Prinzipien mit denen wir in Statistik II eine zweifaktorielle ANOVA umgesetzt hatten. Dafür waren die abhängige Variable (hier subjektive Wahrscheinlichkeit einer schweren Erkrankung nach dem Video, disease2) und die experimentellen Bedingungen (hier Kompetenz comp und Wärme warm) relevant. Darüber hinaus hatten wir die Personen-ID (hier id) benötigt, weil der aov_4() Ansatz auch für messwiederholte Konstellationen eingesetzt werden kann und dafür eine klare Zuordnung der Beobachtungen zu den Personen vonnöten ist. Die ANOVA sieht dann so aus:
library(afex)
ano1 <- aov_4(disease2 ~ comp * warm + (1 | id), roma)
summary(ano1)
## Anova Table (Type 3 tests)
##
## Response: disease2
##           num Df den Df    MSE       F      ges    Pr(>F)
## comp           1    345 391.26 14.8933 0.041382 0.0001358 ***
## warm           1    345 391.26  4.6637 0.013338 0.0314951 *
## comp:warm      1    345 391.26  0.0172 0.000050 0.8957264
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
So können wir Testatistiken berichten, welche generelle Aussagen über die Effekte in eine ja/nein Aussage überführen. Letztlich wird so in den meisten Artikel der klinischen Forschung die extreme Variante des Nullhypothesen-Signifikanz-Testens (NHST) umgesetzt. Anhand der Teststatistik wird festgehalten, dass der Effekt bedeutsam von 0 verschieden ist (z.B. dass es einen Haupteffekt der Kompetenz des Arztes bzw. der Ärztin gibt) und mit dieser binären Interpretation eine Reflektion des theoretischen Frameworks betrieben. An dieser Stelle wäre es aber sicherlich sinnvoll, detaillierter in die Bedeutung dieser Effekt einzutauchen.
Ein bisschen Detail
Eine ANOVA ist letztlich “nur” ein Vergleich von Diskrepanzen zwischen Gruppenuntermittelwerten, welcher ins Verhältnis zu Unterschieden zwischen Personen in den gleichen Gruppen gesetzt wird. Gucken wir uns diese beiden Komponenten also direkt mal an:
# Mittelwerte
means <- aggregate(disease2 ~ comp * warm, roma, mean)
means
##   comp warm disease2
## 1 high high 18.34831
## 2  low high 26.80723
## 3 high  low 23.20430
## 4  low  low 31.10714
# Standardabweichungen
sds <- aggregate(disease2 ~ comp * warm, roma, sd)
sds
##   comp warm disease2
## 1 high high 17.90575
## 2  low high 19.65027
## 3 high  low 20.81573
## 4  low  low 20.60648
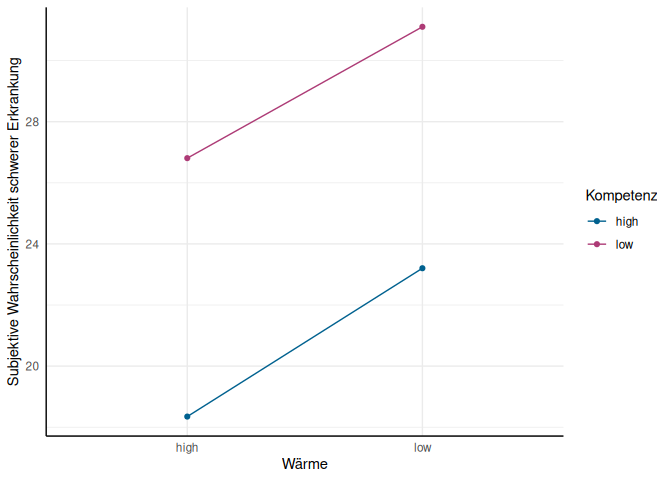
Ich habe mich hier für aggregate() entschieden, weil es mit genau der gleichen Modellsyntax auskommt, mit der wir auch gerade in aov_4() gearbeitet haben und weil wir mit den Ergebnissen (anders als z.B. mit dem Output von describeBy()) sehr leicht weiter arbeiten können. Wir sehen also, dass Personen, die ihre negativ-Befunde von einer kompetenten, warmen Person erhalten auf einer Skala von 0 bis 100 nur lediglich eine 18-prozentige Wahrscheinlichkeit einer schweren Erkrankung wahrnehmen und es im Extremfall bis 31% sein kann.
Wenn wir das Ganze in seine Einzelteile zerlegen wollen, können wir (wie im Bachelor) mit einfachen Regressionen arbeiten. Dort hatten wir noch mit Dummy-Kodierung gearbeitet, wohingegen die ANOVA (und auch die Darstellung im Artikel) mit der Kontrast-Kodierung arbeitet. In der Dummy-Kodierung (die Voreinstellung in R), werden nominalskalierte Prädiktoren mit 0 und 1 kodiert, wodurch Referenzkategorien gesetzt werden, mit denen andere Ausprägungen verglichen werden. Für die beiden experimentellen Bedingungen des Artikels:
# Kompetenz - dummy
contrasts(roma$comp)
##      low
## high   0
## low    1
# Wärme - dummy
contrasts(roma$warm)
##      low
## high   0
## low    1
So ergibt sich die Kombination “hohe Kompetenz, hohe Wärme” als Referenz und in einem Regressionsmodell wird mit dieser Konstellation verglichen:
reg1 <- lm(disease2 ~ comp * warm, roma)
summary(reg1)
##
## Call:
## lm(formula = disease2 ~ comp * warm, data = roma)
##
## Residuals:
##     Min      1Q  Median      3Q     Max
## -31.107 -14.348  -6.107  11.652  66.796
##
## Coefficients:
##                 Estimate Std. Error t value Pr(>|t|)
## (Intercept)      18.3483     2.0967   8.751  < 2e-16 ***
## complow           8.4589     3.0183   2.803  0.00536 **
## warmlow           4.8560     2.9331   1.656  0.09872 .
## complow:warmlow  -0.5561     4.2397  -0.131  0.89573
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
##
## Residual standard error: 19.78 on 345 degrees of freedom
## Multiple R-squared:  0.0534,	Adjusted R-squared:  0.04517
## F-statistic: 6.488 on 3 and 345 DF,  p-value: 0.0002784
Hier ist das Intercept der Mittelwert der Referenzkategorie ($b_0 = $18.35) und z.B. der Effekt von Kompetenz ($b_1 = $ 8.46`) der Unterschied der Mittelwerte aus der Gruppe “hohe Kompetenz, hohe Wärme” und der Gruppe “niedrige Kompetenz, hohe Wärme”.
In der ANOVA-typischen Kontrastkodierung sind die Effekte ein wenig anders zu interpretieren. Wie Sie sich vermutlich erinnern, müssen sich Kontrastkoeffizienten in der ANOVA zu 0 addieren - deswegen werden sie in R contr.sum genannt. In unserem Fall sehen diese Kontraste so aus:
# Kompetenz - Kontrast
contrasts(roma$comp) <- 'contr.sum'
contrasts(roma$comp)
##      [,1]
## high    1
## low    -1
# Wärme - Kontrast
contrasts(roma$warm) <- 'contr.sum'
contrasts(roma$warm)
##      [,1]
## high    1
## low    -1
Mit der Zuweisung der neuen Kontrasteinstellung, wir die Kodierung global geändert. (Wenn wir zur Dummy-Kodierung zurückkehren wollen, müssen wir statt 'contr.sum' an der Stelle 'contr.treatment' setzen.) Wenn wir das Modell mit diesen Kontrasten rechnen:
reg2 <- lm(disease2 ~ comp * warm, roma)
summary(reg2)
##
## Call:
## lm(formula = disease2 ~ comp * warm, data = roma)
##
## Residuals:
##     Min      1Q  Median      3Q     Max
## -31.107 -14.348  -6.107  11.652  66.796
##
## Coefficients:
##             Estimate Std. Error t value Pr(>|t|)
## (Intercept)   24.867      1.060  23.461  < 2e-16 ***
## comp1         -4.090      1.060  -3.859 0.000136 ***
## warm1         -2.289      1.060  -2.160 0.031495 *
## comp1:warm1   -0.139      1.060  -0.131 0.895726
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
##
## Residual standard error: 19.78 on 345 degrees of freedom
## Multiple R-squared:  0.0534,	Adjusted R-squared:  0.04517
## F-statistic: 6.488 on 3 and 345 DF,  p-value: 0.0002784
Im Vergleich zu oben ändern sich so die Interpretationen der einzelnen Regressionskoeffizienten, während das Gesamtmodell (also $R^2$ und dessen Test) gleich bleibt. Hier ist das Intercept $b_0$ jetzt der Mittelwert der Gruppenmittelwerte - als Gegencheck:
mean(means$disease2)
## [1] 24.86675
Die Regressionsgewichte ändern hierbei auch die Bedeutung. So ist der Effekt der Kompetenz ($b_1 =$24.87) jetzt die Abweichung von diesem Durchschnitt, die sich durch die niedrige Kompetenz ergibt. Genau dieses Modell ist auch im Ergebnisobjekt unserer ANOVA hinterlegt - ano1$lm.
Für ein bisschen mehr Übersichtlichkeit solcher Ergebnisse sorgen üblicherweise Bilder (hier noch einmal der Hinweis auf unsere Beiträge zu ggplot2):
library(ggplot2)
ggplot(means, aes(x = warm, y = disease2, group = comp, color = comp)) +
  geom_point() + geom_line() +
  labs(x = 'Wärme', y = 'Subjektive Wahrscheinlichkeit schwerer Erkrankung', color = 'Kompetenz') +
  theme_pandar() + scale_color_pandar()
means$sds <- sds$disease2
pd <- position_dodge(width = 0.2)

ggplot(means, aes(x = warm, y = disease2, group = comp, color = comp)) +
  geom_point(position = pd) + geom_line(position = pd) +
  geom_errorbar(aes(ymin = disease2 - sds, ymax = disease2 + sds), position = pd) +
  labs(x = 'Wärme', y = 'Subjektive Wahrscheinlichkeit schwerer Erkrankung', color = 'Kompetenz') +
  theme_pandar() + scale_color_pandar()
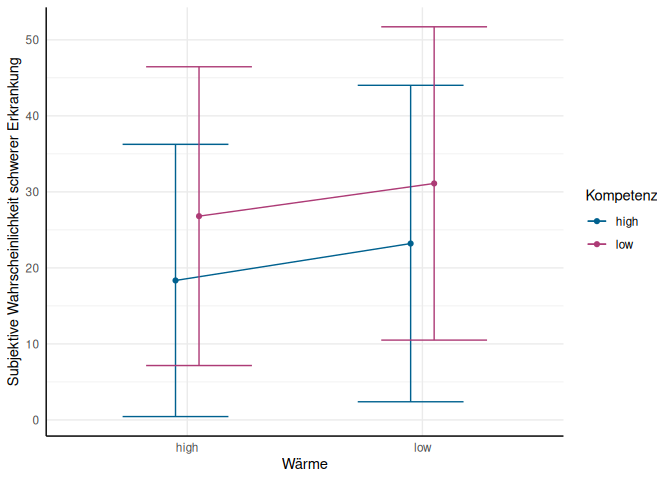
Zu unser aller immensem Glück, haben wir genau ein solches Maß schon in den ersten Wochen von Statistik I im Bachelor kennengelernt. Wenn wir Mittelwertsunterschiede an Streuung innerhalb der Gruppen relativieren, entsteht Cohen’s $d$:
Dafür hatten wir das Paket effsize benutzt, das - wie der Name impliziert - das Berechnen von Effektstärken immens vereinfacht.
# Effektstärke Kompetenz:
effsize::cohen.d(disease2 ~ comp, roma)
##
## Cohen's d
##
## d estimate: -0.4099412 (small)
## 95 percent confidence interval:
##      lower      upper
## -0.6228974 -0.1969850
# Effektstärke Wärme:
effsize::cohen.d(disease2 ~ warm, roma)
##
## Cohen's d
##
## d estimate: -0.224605 (small)
## 95 percent confidence interval:
##       lower       upper
## -0.43585274 -0.01335724
Um der starken Verführung entgegenzuwirken, auch dieses Maß wieder in Kategorien zu interpretieren, können wir uns diese Unterschiede auch in Relation zu den erwartbaren Unterschieden vorstellen. Wenn wir zwei Personen zufällig ziehen, würden wir (unter Annahme der Normalverteilung der Variable) einen Unterschied von knapp 1.13 Standardabweichungen erwarten. Der Effekt der Kompetenz entspricht also ca. 35% des erwarteten “zufälligen” Unterschieds zwischen zwei Personen; ein Ausmaß, dass bei konsistenten Effekten nicht zu vernachlässigen ist.
ANCOVA
In der ANOVA vergleichen wir Gruppenmittelwerte. Soweit erst einmal unproblematisch. Ein Problem entsteht, wenn wir bedenken müssen, dass Gruppen in ihren Eigenschaften eventuell nicht identisch sind. Auch wenn in den klassischen Goldstandarderhebungen der Psychotherapieforschung - den Randomized Controlled Trials - das randomized eigentlich sicherstellen sollte, dass am Ende die Personeneigenschaften in den Gruppen gleich verteilt sind, kann das nicht immer garantiert werden. Wie Sie sicherlich noch aus den Vorlesungen zur Versuchsplanung wissen, funktioniert Randomisierung z.B. erst ab relativ großem $N$ ausreichend zuverlässig. Darüber hinaus können auch in RCTs Proband*innen nicht zur Teilnahme gezwungen werden, wodurch sich systematischer Dropout ergeben kann (z.B. könnten in einer aufwändigen Experimentalbedingung Personen mit niedriger Gewissenhaftigkeit überproportional häufig abbrechen). In dieser Studie ist z.B. die subjektive Wahrscheinlichkeit einer schweren Erkrankung vor der experimentellen Manipulation so verteilt:
aggregate(disease1 ~ comp * warm, roma, mean)
##   comp warm disease1
## 1 high high 43.85393
## 2  low high 45.13253
## 3 high  low 42.84946
## 4  low  low 47.27381
Eine Möglichkeit auf solche Kovariaten zu kontrollieren stellt die ANCOVA dar. Weil unter der Phrase “auf Kovariaten kontrollieren” sehr viel falsch verstanden werden kann, dröseln wir das Konzept an dieser Stelle noch einmal ein bisschen auf.
Um eine Kovariate aufzunehmen, können wir unsere ANOVA aus aov_4() erweitern. Dafür müssen wir lediglich über factorize = FALSE festhalten, dass nun nicht mehr alle Variable auf der rechten Seite der Gleichung in factor umgewandelt werden sollen, weil dort auch intervallskalierte Variablen stehen können:
ano2 <- aov_4(disease2 ~ comp * warm + disease1 + (1 | id), roma, factorize = FALSE)
## Warning: Numerical variables NOT centered on 0 (matters if variable in interaction):
##    disease1
## Contrasts set to contr.sum for the following variables: comp, warm
summary(ano2)
## Anova Table (Type 3 tests)
##
## Response: disease2
##           num Df den Df    MSE        F     ges    Pr(>F)
## comp           1    344 233.09  16.7279 0.04637 5.377e-05 ***
## warm           1    344 233.09   6.8526 0.01953  0.009242 **
## disease1       1    344 233.09 235.0972 0.40597 < 2.2e-16 ***
## comp:warm      1    344 233.09   0.4457 0.00129  0.504848
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
Wie wir sehen entsprechen die Ergebnisse den berichteten Teststatistiken aus dem Artikel. Um aber wieder einen Einblick in die Ergebnisse zu erhalten, können wir uns wieder die Regression angucken (lassen Sie sich nicht von dem exzessiv langen output einschüchtern, wenn Sie den Befehl bei sich selbst ausführen):
summary(ano2$lm)
## Residuals:
##     Min      1Q  Median      3Q     Max
## -50.242  -9.367  -1.728   8.573  52.661
##
## Coefficients:
##             Estimate Std. Error t value Pr(>|t|)
## (Intercept)  1.66938    1.71995   0.971  0.33243
## comp1       -3.35182    0.81952  -4.090 5.38e-05 ***
## warm1       -2.14174    0.81816  -2.618  0.00924 **
## disease1     0.51806    0.03379  15.333  < 2e-16 ***
## comp1:warm1 -0.54644    0.81854  -0.668  0.50485
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
##
## Residual standard error: 15.27 on 344 degrees of freedom
## Multiple R-squared:  0.4377,	Adjusted R-squared:  0.4312
## F-statistic: 66.94 on 4 and 344 DF,  p-value: < 2.2e-16
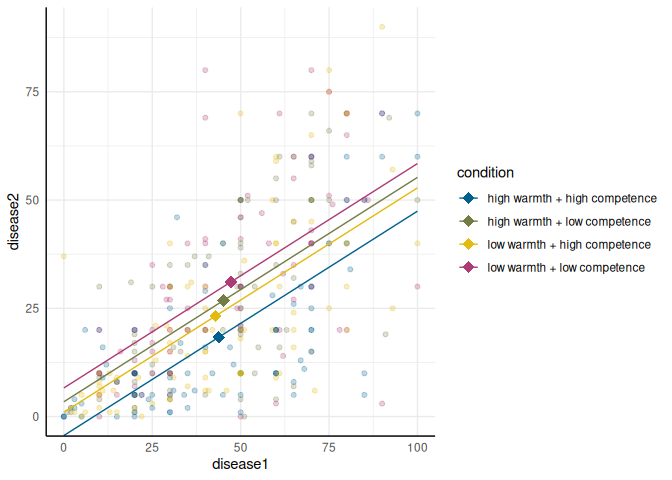
Gucken wir uns am Besten wieder mit ein paar Abbildung an, was dieser Ergebnisse heißen sollen. In der ANOVA hatten wir die globalen Mittelwerte verglichen (als Karos in der Abbildung gekennzeichnet).
# Mittelwerte zusammenführen
tmp <- expand.grid(disease1 = 50,
  warm = levels(roma$warm),
  comp = levels(roma$comp))
tmp$disease2 <- predict(ano2$lm,
  newdata = tmp)
tmp$condition <- factor(tmp$warm:tmp$comp, labels = levels(roma$condition))

# Plot erstellen
ggplot(roma, aes(x = disease1, y = disease2, group = condition, color = condition)) +
  geom_point(alpha = .25) +
  geom_line(data = lines, aes(group = condition, color = condition)) +
  scale_color_pandar() + theme_pandar() + coord_cartesian(ylim = range(roma$disease2, na.rm = TRUE), xlim = range(roma$disease1, na.rm = TRUE)) +
  geom_point(data = tmp, aes(x = disease1, y = disease2, color = condition), size = 4, pch = 18)
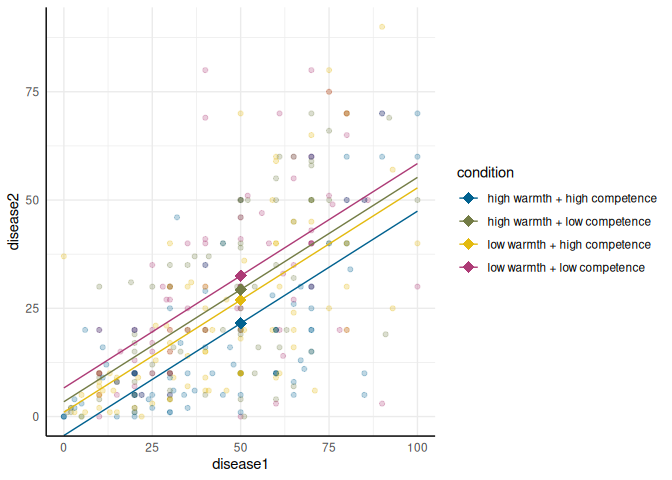
Dieser bedingte Vergleich wird im ANCOVA Modell in den Gewichten der Gruppierungsvariablen festgehalten. Wie immer in Regression ist die korrekte Interpretation der Regressionsgewichte also “der Unterschied zwischen zwei Personen, die sich in $x$ um eine Einheit unterscheiden, wenn alle anderen Prädiktoren gleich sind”. Gerade durch die Kombination mit der Kontrast-Kodierung erfordert die Interpretation ein bisschen Geschick. Zur Erinnerung:
contrasts(roma$warm)
##      [,1]
## high    1
## low    -1
und das Regressionsgewicht von comp1 aus unserem Modell:
##      Estimate    Std. Error       t value      Pr(>|t|)
## -3.351823e+00  8.195217e-01 -4.089975e+00  5.377187e-05
Hier ist also die Aussage, dass eine Person aus der Gruppe “high warmth” ($x_1 = 1$) sich von einer Person aus einer “durchschnittlichen” Gruppe ($x_1 = 0$) um -3.35 Einheiten unterscheidet, gegeben Sie kommt aus der “durchschnittlichen” Kondition hinsichtlich der Kompetenz ($x_2$) und hat mit dem gleichen Wert der subjektiven Wahrscheinlichkeit ($x_3$) das Experiment gestartet. Weil Personen aus der “low warmth” Bedingung den Wert $x_1 = -1$ haben, ist der vorhergesagte Unterschied zwischen Personen aus entgegengesetzten Bedingungen (high vs. low) $2 \times -3.35 = -6.7$.
Im Gegensatz zur ANOVA wird hier also explizit darauf eingegangen, dass wir Personen nur dann direkt über Gruppen hinweg vergleichen sollten, wenn sie mit der gleichen Ausprägung auf der subjektiven Wahrscheinlichkeit gestartet sind. Das erzeugt allerdings immer dann Probleme, wenn die Gruppen, die wir untersuchen, nur wenig bis keine Überlappung in den Ausprägungen solcher Kontrollvariablen haben (z.B. wenn wir die Effektivität von Förderprogrammen bei Lernstörungen mit dem “treatment-as-usual” von anderen Schüler*innen vergleichen wollen).
Change-Modelle
Eine naheliegende Alternative zu den ANCOVA Modellen ist es, statt des zweiten Zeitpunkts die Veränderung zwischen den Zeitpunkten $Y_2 - Y_1$ durch die Gruppen vorherzusagen. Mit dem Vergleich dieser, sogenannten “Change-Modelle” mit der ANCOVA haben sich diverse Studien und methodische Arbeiten befasst. Ein klassisches Argument gegen die ANCOVA ist Lord’s Paradox, in dem es zu unterschiedlichen Ergebnissen kommt, je nachdem ob man eine Veränderung mit einer ANCOVA oder einem Veränderungsmodell analysiert, wenn die Gruppen sich zum 1. Messzeitpunkt unterscheiden.
Lord's Paradox
Im ursprünglichen Kommentar von Lord (1967) wird eine Situation beschrieben, in der eine Universität ihr Mensa-Essen evaluieren möchte. Dazu wird das Gewicht von Männern und Frauen zu Beginn des Wintersemesters und zum Ende des folgenden Sommersemesters erhoben. Nehmen wir als extremes Beispiel, dass beide Gruppen im Mittel 5kg zugelegt hätten:
# Seed festlegen
set.seed(123)

# Werte Frauen
y1f <- rnorm(100, 70, 10)
y2f <- 5 + .5*y1f + rnorm(100, 35, sqrt(75))

# Werte Männer
y1m <- rnorm(100, 80, 10)
y2m <- 5 + .5*y1m + rnorm(100, 40, sqrt(75))

# Datensatz
d <- data.frame(y1 = c(y1f, y1m), y2 = c(y2f, y2m),
  g = rep(c('f', 'm'), each = 100))
In den Termini des bisherigen Beitrags ist das Geschlecht die Gruppen-Zuweisung. Wenn wir also untersuchen wollen, ob es einen Effekt der Variable Geschlecht gibt und dabei eventuelle Unterschiede in der Baseline berücksichtigen wollen (die es ja gibt), finden wir einen signifikanten Effekt:
# ANCOVA
lord_ancova <- lm(y2 ~ y1 + g, d)
summary(lord_ancova)
##
## Call:
## lm(formula = y2 ~ y1 + g, data = d)
##
## Residuals:
##     Min      1Q  Median      3Q     Max
## -21.144  -5.735  -0.255   5.707  28.513
##
## Coefficients:
##             Estimate Std. Error t value Pr(>|t|)
## (Intercept)  42.1819     4.7876   8.811 6.48e-16 ***
## y1            0.4561     0.0664   6.869 8.26e-11 ***
## gm            6.0700     1.4081   4.311 2.57e-05 ***
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
##
## Residual standard error: 8.703 on 197 degrees of freedom
## Multiple R-squared:  0.3858,	Adjusted R-squared:  0.3795
## F-statistic: 61.86 on 2 and 197 DF,  p-value: < 2.2e-16
Die ANCOVA würde uns also zurückmelden, dass das Geschlecht selbst nach Kontrolle auf die Baselineunterschiede einen signifikanten Effekt auf die Gewichtszunahme hat. Wenn wir aber die Veränderung zwischen den Zeitpunkten betrachten, finden wir keinen signifikanten Effekt:
# Change-Modell
lord_change <- lm(y2 - y1 ~ g, d)
summary(lord_change)
##
## Call:
## lm(formula = y2 - y1 ~ g, data = d)
##
## Residuals:
##     Min      1Q  Median      3Q     Max
## -23.779  -6.559   0.180   6.187  34.545
##
## Coefficients:
##             Estimate Std. Error t value Pr(>|t|)
## (Intercept)   3.6166     1.0052   3.598 0.000405 ***
## gm            0.4674     1.4215   0.329 0.742656
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
##
## Residual standard error: 10.05 on 198 degrees of freedom
## Multiple R-squared:  0.0005457,	Adjusted R-squared:  -0.004502
## F-statistic: 0.1081 on 1 and 198 DF,  p-value: 0.7427
Frauen verändern sich bedeutsam (im Intercept dargestellt) und die Veränderung der Männer unterscheidet sich nicht bedeutsam (im Regressionsgewicht dargestellt). Dieses Artefakt wird seither als Lord’s Paradox bezeichnet.
Wenn wir einen Change-Ansatz nutzen möchten, um die Effekte zu untersuchen, sieht das relativ einfach so aus:
# Change-Modell
reg3 <- lm(disease2 - disease1 ~ warm * comp, roma)

# Ergebniszusammenfassung
summary(reg3)
##
## Call:
## lm(formula = disease2 - disease1 ~ warm * comp, data = roma)
##
## Residuals:
##     Min      1Q  Median      3Q     Max
## -70.833 -12.833   1.645  14.645  56.645
##
## Coefficients:
##             Estimate Std. Error t value Pr(>|t|)
## (Intercept) -19.9107     1.0306 -19.320   <2e-16 ***
## warm1        -2.0048     1.0306  -1.945   0.0525 .
## comp1        -2.6647     1.0306  -2.586   0.0101 *
## warm1:comp1  -0.9255     1.0306  -0.898   0.3698
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
##
## Residual standard error: 19.23 on 345 degrees of freedom
## Multiple R-squared:  0.03169,	Adjusted R-squared:  0.02327
## F-statistic: 3.764 on 3 and 345 DF,  p-value: 0.01106
Numerisch unterscheiden sich die Effekte gegenüber der ANCOVA - besonders auffällig ist dabei, dass in diesem Kontext der Effekt der Wärme so reduziert wird, dass er nicht bedeutsam ausfällt. Deshalb, kann es wichtig sein, die Interpretation der Effekte hier noch einmal genauer unter die Lupe zu nehmen. In diesem Fall ist das Intercept die Verringerung der subjektiven Wahrscheinlichkeit einer ernsthaften Krankheit, wenn der Negativbefund von einem durchschnittlichen Arzt übermittelt wird. Wenn der Arzt empathisch ist (“high warmth”), verringert sich diese um zusätzliche -2 Einheiten (was keinen statistisch bedeutsamen Unterschied darstellt). Wenn der Arzt kompetent ist (“high competence”), ist diese zusätzliche Verringerung hingegen statistisch bedeutsam. Allerdings sei an dieser Stelle - ganz im Sinne der Effektstärke, die wir oben besprochen hatten - darauf hingewiesen, dass die Wärme und Kompetenz des Arztes nur ca. 3% der interindividuellen Unterschiede in der Veränderung der wahrgenommenen Krankheitswahrscheinlichkeit ausmachen.
Wenn wir dieses Modell jetzt in eine ANOVA überführen:
# Change zur ANOVA
anova(reg3)
## Analysis of Variance Table
##
## Response: disease2 - disease1
##            Df Sum Sq Mean Sq F value  Pr(>F)
## warm        1   1428 1428.24  3.8613 0.05021 .
## comp        1   2450 2450.01  6.6237 0.01048 *
## warm:comp   1    298  298.28  0.8064 0.36981
## Residuals 345 127609  369.88
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
Entspricht der Test der condition genau dem Test, den wir für den Interaktionseffekt in der Messwiederholten ANOVA erhalten hätten. (Probieren Sie es gerne mit der Messwiederholten ANOVA aus!) Letztlich ist die Entscheidung zwischen Change-Model oder ANCOVA also die gleiche wie die zwischen Messwiederholter ANOVA und ANCOVA.
Wenn Sie eine Interventionsstudie durchführen, für welchen der beiden Ansätze sollten Sie sich jetzt also Entscheiden? Generell gibt es ein paar handfeste Empfehlungen: van Breukelen (2013) konnte zeigen, dass beide Ansätze zu den gleichen Ergebnissen führen, wenn die Gruppen randomisiert zugewiesen werden, in solchen Fällen aber die ANCOVA mehr Power hat. Wenn “natürliche” Gruppen verglichen werden, die sich in der Variable vor der Intervention unterscheiden können und die Kovariaten mit Messfehler behaftet sind, wird generell empfohlen den Change-Ansatz zu verwenden. Lüdtke und Robitzsch (2023) zeigen darüber hinaus, dass der Change-Ansatz dann genutzt werden sollte, wenn nicht alle potentiellen Kovariaten erhoben wurden, weil es in diesem Ansatz (unter der Annahme, dass die Konfundierung zu allen Zeitpunkten identisch ist) durch die Bildung der Differenz nicht notwendig ist, alle Kovariaten in das Modell aufzunehmen. Allerdings wird dabei Vorausgesetzt, dass das Outcome zum 1. Messzeitpunkt keine Auswirkung auf die Gruppenzuordnung hat. In Fällen, in denen vorab eine sinnvolle und stichhaltige Erhebung potentieller Störvariablen geplant wurde, ist die Nutzung der ANCOVA empfehlenswert, sofern sie nicht aufgrund von Baselineunterschieden in Variablen mit fehlenden Werte zu potentiellen Problemen des Lord’s Paradox führt.
Generalisierte ANCOVA
Die oben vorgestellte ANCOVA lässt sich nach Belieben um mehr Kovariaten erweitern. Das sollte (wie gerade besprochen) auch passieren, da sie besonders dann gut geeignet ist, wenn auf viele relevante Störvariablen kontrolliert werden kann. Dabei gehen wir bereits etwas über die ursprüngliche Auswertung von Kube & Seewald hinaus, die nur die Baselinevariable als Kovariate genutzt hatten. Das Besondere an der ANCOVA ist aber, dass wir sie in den Fall der generalisierten ANCOVA erweitern können, um differentielle Interventionseffekt aufzudecken und so immer detailliertere, personalisiertere Empfehlungen geben zu können.
Für den hier untersuchten Fall könnte sich zum Beispiel die Annahme einschleichen, dass Personen mit sehr hohen Werten der subjektiven Wahrscheinlichkeit einer ernsthaften Erkrankung besonders stark von einfühlsamer und/oder kompetenter ärztlicher Betreuung profitieren könnten. Technisch ist die Umsetzung erneut denkbar einfach:
ano3 <- aov_4(disease2 ~ comp * warm * disease1 + (1 | id), roma, factorize = FALSE)
## Warning: Numerical variables NOT centered on 0 (matters if variable in interaction):
##    disease1
## Contrasts set to contr.sum for the following variables: comp, warm
summary(ano3)
## Anova Table (Type 3 tests)
##
## Response: disease2
##                    num Df den Df    MSE        F     ges Pr(>F)
## comp                    1    341 233.89   2.6057 0.00758 0.1074
## warm                    1    341 233.89   0.4863 0.00142 0.4861
## disease1                1    341 233.89 233.2718 0.40620 <2e-16 ***
## comp:warm               1    341 233.89   0.3345 0.00098 0.5634
## comp:disease1           1    341 233.89   0.1201 0.00035 0.7291
## warm:disease1           1    341 233.89   0.4008 0.00117 0.5271
## comp:warm:disease1      1    341 233.89   1.0810 0.00316 0.2992
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
Das Einzige, das wir in diesem Fall ändern ist, dass wir mit dem * auch die Interaktion zwischen den experimentellen Bedingungen und der Baselinevariable zulassen. Wie Sie inzwischen vielleicht festgestellt haben, bin ich ein Freund der grafischen Aufbereitung:
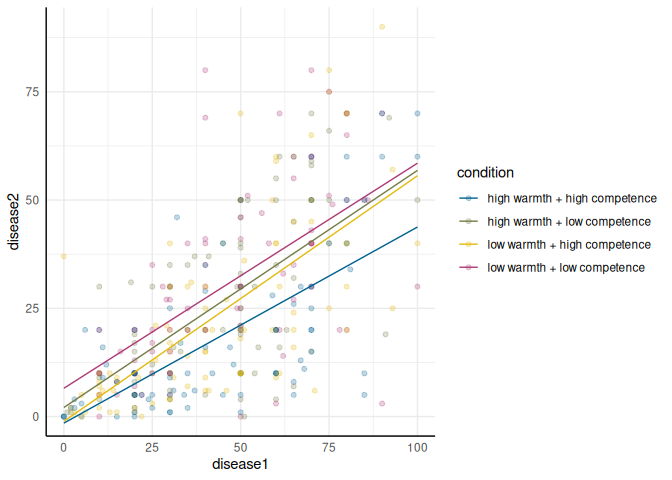
Da keiner der Effekte (außer der Zusammenhang zwischen Baseline und Post-Erhebung) statistisch bedeutsam ist, sind alle folgenden Sätze lediglich anekdotische Spekulation, die ich hier mal festhalte, um das Potential der generalisierten ANCOVA aufzuzeigen. Rein optisch zeigt sich, dass bei geringen Ausprägungen der subjektiven Wahrscheinlichkeit zur Baseline die Wärme eines komptenten Arztes bzw. einer kompetenten Ärztin sehr viel weniger relevant ist, als bei starker subjektiver Krankheitswahrscheinlichkeit (daran zu erkennen, dass die gelbe und die blaue Linien sich auseinander entwickeln). Dieser Effekt führt sogar dazu, dass die Kompetenz keinen wesentlichen Einfluss mehr hat, wenn die Ärztin/der Arzt kalt sind und Patient*innen mit einer sehr hohen subjektiven Krankeitheitswahrscheinlichkeit in die Befundbesprechung hineingehen. Intuitiv scheinen diese Effekt nachvollziehbar, aber zumindest angesichts der vorhandenen Teststärke sind sie nicht bedeutsam.
Moderierte Regression
In der ANOVA hatten wir bereits eine Interaktion zwischen zwei nominalskalierten Variablen (die beiden Experimentalbedingungen), welche erlaubt, dass durch Kombinationen von Interventionen andere Effekte entstehen, als man bei durch pure Addition der Effekte erwarten würde (ein klassisches Beispiel hierfür ist, dass der Effekt von Psychotherapie bei mittel- bis schwergradiger Depression durch die hinzunahme von Psychopharmaka drastisch verstärkt werden kann). In der generalisierten ANCOVA kam gerade die Interaktion zwischen einer nominalskalierten und einer intervallskalierten Variable hinzu. Diese hat erlaubt, dass z.B. der Effekt einer Intervention von der Symptomschwere vor der Behandlung (manche Interventionen können besser für mittelgradige, andere besser für schwere Depression geeignet sein) oder anderen Personeneigenschaften sein kann. Im letzten Schritt fehlt jetzt noch die Interaktion zwischen zwei intervallskalierten Variablen, wodurch der Zusammenhang zwischen einer Personeneigenschaft und dem Outcome von einer anderen Personeneigenschaft abhängen kann. Diese Konstellation hatten wir bereits in Statistik II behandelt - hier gucken wir uns das Ganze nochmal im Kontext des Artikels von Kube und Seewald (2026) an.
Bei den bisherigen Analysen hatten wir die Implikation hingenommen, dass die Zuweisung zu einer experimentellen Bedingung (der Arzt bzw- die Ärztin wird als kompetent dargestellt) die Ursache für eine Änderung in der subjektiven Wahrsceinlichkeit einer ernsthaften Krankheit ist. Dieser Idee liegt aber eigentlich die Annahme zugrunde, dass die Darstellungen in den Videos auch so wahrgenommen werden, wie sie intendiert sind. Bei manchen Personen, könnte das “kompetente Video” z.B. einfach nicht den Eindruck einer kompetenten Person erwecken und somit keinen Effekt zeigen. Bei Kube und Seewald (2026) wird dieser Punkt als perceptual-level model bezeichnet und in den Zusatzanalysen als Ergänzung zum Artikel dargestellt.
Umsetzung mit lm
Bevor wir in moderierter Regression irgendwas rechnen, errinern wir uns an das, was wir in den Beiträgen zu moderierter und nicht-linearer Regression im Bachelor detailliert begründet hatten: wir müssen die Variablen zentrieren, um nicht-essentielle Multikollinearität zu minimieren und unsere Ergebnisse interpretierbarer zu machen. Also, der erste Schritt:
roma$warm_cent <- scale(roma$warm_perc, scale = FALSE)
roma$comp_cent <- scale(roma$comp_perc, scale = FALSE)
Mit diesen zentrierten Variablen können wir jetzt mit dem üblichen lm()-Befehl eine moderierte Regression berechnen:
mod1 <- lm(disease2 ~ warm_cent * comp_cent + disease1, roma)
summary(mod1)
##
## Call:
## lm(formula = disease2 ~ warm_cent * comp_cent + disease1, data = roma)
##
## Residuals:
##     Min      1Q  Median      3Q     Max
## -34.305  -8.837  -0.304   7.779  40.067
##
## Coefficients:
##                      Estimate Std. Error t value Pr(>|t|)
## (Intercept)          1.887130   1.583180   1.192 0.234088
## warm_cent           -0.355288   0.098056  -3.623 0.000335 ***
## comp_cent           -0.686631   0.103121  -6.658  1.1e-10 ***
## disease1             0.500382   0.029676  16.862  < 2e-16 ***
## warm_cent:comp_cent  0.009997   0.009239   1.082 0.280008
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
##
## Residual standard error: 13.39 on 344 degrees of freedom
## Multiple R-squared:  0.5678,	Adjusted R-squared:  0.5627
## F-statistic:   113 on 4 and 344 DF,  p-value: < 2.2e-16
Hier sehen wir, dass die von uns produzierten Ergebnisse zumindest schon einmal hinsichtlich der Signifikanzmuster konsistent mit dem sind, was im Supplement (S. 18) berichtet wird. Allerdings scheinen die Regressionsgewichte nicht dem zu entsprechen, was wir hier erzeugt haben. In englischsprachiger Literatur ist das $\beta$ für Regressionsgewichte häufig ein Hinweis darauf, dass es sich hier um standardisierte Regressionsgewichte handelt. In altbekannter Weise, nutzen wir also noch lm.beta() aus dem gleichnnamigen Paket und übergeben die Ergebnisse erst dann an die summary():
library(lm.beta)
lm.beta(mod1) |> summary()
##
## Call:
## lm(formula = disease2 ~ warm_cent * comp_cent + disease1, data = roma)
##
## Residuals:
##     Min      1Q  Median      3Q     Max
## -34.305  -8.837  -0.304   7.779  40.067
##
## Coefficients:
##                      Estimate Standardized Std. Error t value Pr(>|t|)
## (Intercept)          1.887130           NA   1.583180   1.192 0.234088
## warm_cent           -0.355288    -0.159739   0.098056  -3.623 0.000335 ***
## comp_cent           -0.686631    -0.294312   0.103121  -6.658  1.1e-10 ***
## disease1             0.500382     0.600157   0.029676  16.862  < 2e-16 ***
## warm_cent:comp_cent  0.009997     0.038651   0.009239   1.082 0.280008
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
##
## Residual standard error: 13.39 on 344 degrees of freedom
## Multiple R-squared:  0.5678,	Adjusted R-squared:  0.5627
## F-statistic:   113 on 4 and 344 DF,  p-value: < 2.2e-16
In diesem Fall zeigt sich keine bedeutsame Interaktion zwischen den beiden Eigenschaften, sodass wir unsere Regressionsgewichte grob in gleicher Weise interpretieren können, wie immer: bei gleicher wahrgenommener Kompetenz und subjektiver Krankheitswahrscheinlichkeit vor dem Negativbefund, sagen wir einen Unterschied von -0.36 Einheiten vorher, wenn sich zwei Personen um einen Punkt in der wahrgenommenen Wärme unterscheiden. Erneut möchte ich an dieser Stelle darauf hinweisen, dass die gängige Floskel von “verändert sich A um B Einheiten” sowohl falsch als auch immens fehlleitend ist - insbesondere in der Psychotherapieforschung. Worüber wir mit diesen Ergebnissen Aussagen machen sind unterschiede zwischen Personen, noch dazu häufig korrelative Unterschiede. Die Formulierung “verändert sich” impliziert aber, dass wir eine Veränderung innerhalb einer Person verursachen könnten. Die Probleme dieser Gleichsetzung werden als Ergodizitätsproblem bezeichnet und stellen eine immense Herausfoderung für die meisten psychologischen Befunde in der Überführung in die individual-Praxis dar. Insbesondere in unseren Betrachtungen zu längsschnittlichen Netzwerkmodellen werden wir noch einmal genauer darauf eingehen.
Intepretation von moderierter Regression
Für den Fall der Wahrscheinlichkeitseinschätzung einer ernsthaften Krankheit im Allgemeinen finden sich bei Kube und Seewald (2026) keine Interkationseffekte zwischen Wärme und Kompetenz des ärztlichen Fachkraft. Anders sieht es aber bei der Betrachtung der Wahrscheinlichkeit von Darmkrebs im Spezifischen. Dort sehen die Ergebnisse so aus:
mod2 <- lm(cancer2 ~ warm_cent * comp_cent + cancer1, roma)
lm.beta(mod2) |> summary()
##
## Call:
## lm(formula = cancer2 ~ warm_cent * comp_cent + cancer1, data = roma)
##
## Residuals:
##     Min      1Q  Median      3Q     Max
## -35.643  -7.486  -0.781   5.339  48.571
##
## Coefficients:
##                      Estimate Standardized Std. Error t value Pr(>|t|)
## (Intercept)          1.561875           NA   1.262124   1.237 0.216747
## warm_cent           -0.280960    -0.140025   0.091002  -3.087 0.002183 **
## comp_cent           -0.735019    -0.349230   0.095754  -7.676 1.71e-13 ***
## cancer1              0.405657     0.549658   0.027003  15.022  < 2e-16 ***
## warm_cent:comp_cent  0.030714     0.131630   0.008583   3.579 0.000395 ***
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
##
## Residual standard error: 12.43 on 344 degrees of freedom
## Multiple R-squared:  0.5423,	Adjusted R-squared:  0.537
## F-statistic: 101.9 on 4 and 344 DF,  p-value: < 2.2e-16
Durch eine Interaktion werden die Regressionsgewichte mitunter ein bisschen eigenwilliger in ihrer Interpretation, daher kurz ein paar Formeln, falls sie es genauer nachvollziehen möchten:
Ein paar Formeln, falls Sie es genauer nachvollziehen möchten
Zunächst schreiben wir unsere Regressionsgleichung in allgemeiner Notation:
Dabei ist $Y$ die Krebsangst zum zweiten Messzeitpunkt, $X$ die wahrgenommene Wärme und $Z$ die wahrgenommene Kompetenz des Arztes bzw. der Ärztin. Mit $C$ berücksichtigen wir zusätzlich die Krebsangst zum ersten Messzeitpunkt als Kontrollvariable.
Mit den geschätzten Regressionsgewichten ergibt sich:
Betrachten wir zwei Personen mit $X_1 = 0$, $X_2 = 1$ und $Z_1 = Z_2 = 0$. Beide nehmen ihren Arzt bzw. ihre Ärztin also als durchschnittlich kompetent wahr. Die zweite Person nimmt ihn bzw. sie lediglich als um eine Einheit wärmer wahr. Da wir für die Krebsangst zum ersten Messzeitpunkt kontrollieren, setzen wir diese bei beiden Personen auf denselben Wert, nämlich den Stichprobenmittelwert von $36.069$.
Für die beiden Personen erhalten wir:
Die beiden unterscheiden sich also um $\beta_1 = -0.281$ Einheiten in ihrer vorhergesagten Krebsangst. Dieses Regressionsgewicht entspricht der Steigung der Regressionsgeraden für Personen, die ihren Arzt bzw. ihre Ärztin als durchschnittlich kompetent wahrnehmen. Eine um eine Einheit höhere wahrgenommene Wärme geht hier also mit einer um 0.281 Punkte geringeren vorhergesagten Krebsangst einher.
Wenn beide Personen ihren Arzt bzw. ihre Ärztin als etwas kompetenter wahrnehmen würden ($Z_1 = Z_2 = 1$), sähe das Ganze so aus:
Der Unterschied zwischen den beiden beträgt nun also $\beta_1 + \beta_3 = -0.281 + 0.031 = -0.250$.
Die Steigung der Regressionsgeraden von wahrgenommener Wärme auf Krebsangst verändert sich also für jede zusätzliche Einheit wahrgenommener Kompetenz um $\beta_3 = 0.031$.
Da der Interaktionskoeffizient positiv ist, wird der negative Zusammenhang zwischen wahrgenommener Wärme und Krebsangst mit zunehmender wahrgenommener Kompetenz schwächer. Genau diese Veränderung der Steigung stellt die untersuchte Moderation dar.
Wichtig ist dabei, dass wir in beiden Vergleichen die Krebsangst zum ersten Messzeitpunkt konstant gehalten haben. Dadurch können wir die vorhergesagten Unterschiede in der späteren Krebsangst bei gleichem Ausgangsniveau betrachten.
Bei durchschnittlicher wahrgenommener Kompetenz ist der Effekt der Wärme als bedeutsam, allerdings wird er (weil die Interaktion positiv ist) bei höherer Kompetenz weniger relevant.
Simple Slopes
In vielen Fällen wird die Interpretation von empirischen Ergebnissen durch ein Bild etwas einfacher. Dies gilt meiner Ansicht nach insbesondere für moderierte Regression, weil wir so besser einschätzen können, ob z.B. eine negative Moderation bedeutet, dass ein Effekt abgeschwächt wird, sich in gänze umkehrt oder erst ab einem gewissen Level des Moderators tatsächlich auftritt. Traditionellerweise werden dafür sogenannte simple slopes eingesetzt - also die Vereinfachung von Regressionen mit Interaktionseffekt in Spezialfälle, bei denen man die Regression für ausgewählte Ausprägung eines Moderators betrachtet. Weil moderierte Regression einfach durch die Multiplikation von zwei Variablen entsteht, ist es vollkommen uns überlassen, ob wir zwischen “Prädiktor” und “Moderator” unterscheiden wollen und falls ja, welche von beiden Variablen welche ist. Für diesen Fall lege ich die Wärme als Prädiktor fest und möchte wissen, in welchem Ausmaß die Relevanz der Wärme als Prädiktor für die subjektive Krebswahrscheinlichkeit von der Kompetenz des Arztes bzw. der Ärztin abhängt.
In den meisten Fällen werden für simple slopes drei Ausprägungen verwendet - der Mittelwert des Moderators, sowie eine Standardabweichung drunter und drüber. So können wir einen Eindruck für die Effekte bei den meisten Personen gewinnen. Statt händisch in die Regression die jeweiligen Werte einsetzen zu müssen, können wir das interactions-Paket nutzen. Für unseren Fall:
library(interactions)
sim_slopes(mod2, pred = warm_cent, modx = comp_cent)
## JOHNSON-NEYMAN INTERVAL
##
## When comp_cent is OUTSIDE the interval [3.22, 22.13], the slope of warm_cent is p < .05.
##
## Note: The range of observed values of comp_cent is [-20.48, 13.52]
##
## SIMPLE SLOPES ANALYSIS
##
## Slope of warm_cent when comp_cent = -8.676678e+00 (- 1 SD):
##
##    Est.   S.E.   t val.      p
## ------- ------ -------- ------
##   -0.55   0.12    -4.45   0.00
##
## Slope of warm_cent when comp_cent = -1.486236e-15 (Mean):
##
##    Est.   S.E.   t val.      p
## ------- ------ -------- ------
##   -0.28   0.09    -3.09   0.00
##
## Slope of warm_cent when comp_cent =  8.676678e+00 (+ 1 SD):
##
##    Est.   S.E.   t val.      p
## ------- ------ -------- ------
##   -0.01   0.11    -0.13   0.90
Der Output umfasst zwei Abschnitte. Zuerst das Johnson-Newman Interval, welches angibt, in welchem Bereich des Moderators (hier: Kompetenz) der Prädiktor (hier: Wärme) statistisch bedeutsamen Einfluss hat. Wir sehen hier also, dass die Wärme der Ärztin bzw. des Arztes dann relevant ist, wenn die Kompetenz als durchschnittlich oder weniger eingeschätzt wird. Bei überdurchschnittlicher Kompetenz, scheint die Wärme irrelevant zu werden.
Die Simple-Slope Analysis zeigt dann noch einmal, wie stark die Regressionsgewichte bei -1 SD, Mittelwert und +1 SD ausfallen. Diesen Abschnitt können wir uns auch in Bilder übersetzen lassen:
interact_plot(mod2, pred = warm_cent, modx = comp_cent)
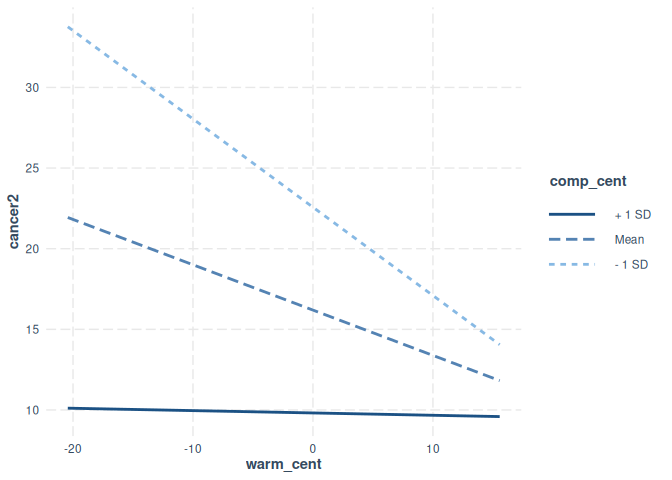
Hier ist zu sehen, dass höhere Kompetenz generell von Vorteil zu sein scheint (was wir an den Regressionsergebnissen bereits deutlich erkennen konnten) und dass die Regressiongerade bei überdurchschnittlicher Kompetenz (+1 SD) quasi horizontal bei sehr niedriger Risikoeinschätzung verläuft. Wenn wir Moderator und Prädiktor die Rollen tauschen lassen, ergibt sich hingegen ein anderes Bild:
interact_plot(mod2, modx = warm_cent, pred = comp_cent)
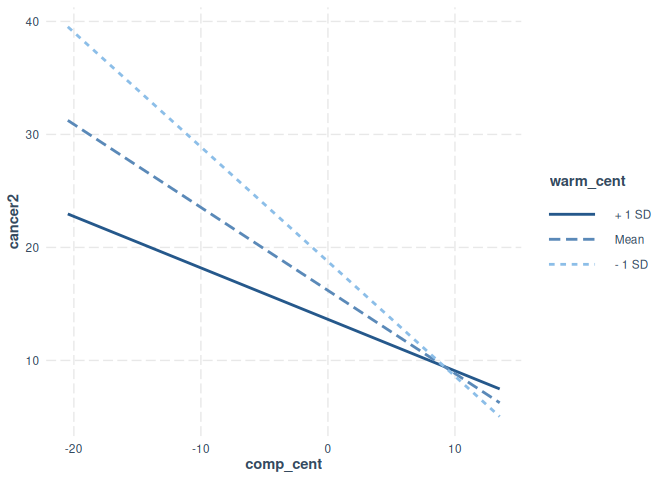
Insgesamt scheint die treffendste Interpretation der Ergebnisse an dieser Stelle also, dass sich die negativen Effekte niedriger Kompetenz durch Wärme abpuffern lassen.
Literatur
Hamaker, E. L., & Schuurman, N. K. (2025). Ergodicity in psychology. MATILDA Preprints. https://matilda.fss.uu.nl/articles/ergodicity-in-psychology.html
Hayes-Larson, E., Kezios, K. L., Mooney, S. J., & Lovasi, G. (2019). Who is in this study, anyway? Guidelines for a useful Table 1. Journal of Clinical Epidemiology, 114, 125–132. https://doi.org/10.1016/j.jclinepi.2019.06.011
Kube, T., & Seewald, A. (2026). Influence of physician behaviors on how patients interpret normal test results. The Annals of Family Medicine, 24(5), 391–398. https://doi.org/10.1370/afm.250671
Lord, F. M. (1967). A paradox in the interpretation of group comparisons. Psychological Bulletin, 68(5), 304–305. https://doi.org/10.1037/h0025105
Lüdtke, O., & Robitzsch, A. (2025). ANCOVA versus change score for the analysis of two-wave data. The Journal of Experimental Education, 93(2), 363–395. https://doi.org/10.1080/00220973.2023.2246187
Tennant, P. W. G., Tomova, G. D., Murray, E. J., Arnold, K. F., Fox, M. P., & Gilthorpe, M. S. (2023). Lord’s ‘paradox’ explained: The 50-year warning on the use of ‘change scores’ in observational data [Preprint]. arXiv. https://doi.org/10.48550/arXiv.2302.01822
van Breukelen, G. J. P. (2013). ANCOVA versus change from baseline in nonrandomized studies: The difference. Multivariate Behavioral Research, 48(6), 895–922. https://doi.org/10.1080/00273171.2013.831743